 Dịch vụ
 Công nghệ
 Về Renova
 Khách hàng


Vector Database là gì? Cơ sở dữ liệu vector cho ứng dụng AI
Chia sẻ bài viết


Mục lục
Khi xây dựng chatbot nội bộ, công cụ tìm kiếm bằng ngôn ngữ tự nhiên hay hệ thống gợi ý sản phẩm, doanh nghiệp thường cần Vector Database để lưu trữ và tìm kiếm dữ liệu theo ngữ nghĩa.
Vậy Vector Database là gì, hoạt động như thế nào và đâu là giải pháp phù hợp cho doanh nghiệp sử dụng AWS? Bài viết sẽ giúp bạn hiểu rõ các khái niệm này để đưa ra lựa chọn phù hợp.
Vector Database là gì?
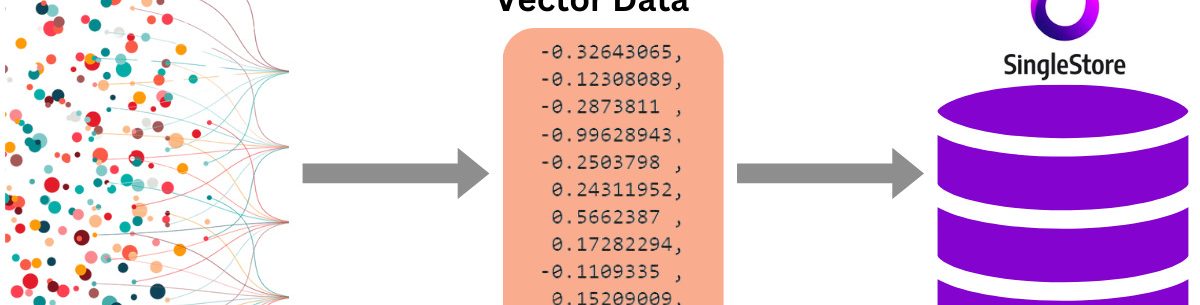
Vector Database (cơ sở dữ liệu vector) là loại cơ sở dữ liệu chuyên lưu trữ, đánh chỉ mục và tìm kiếm các vector embedding. Embedding là dãy số do mô hình AI tạo ra để biểu diễn ý nghĩa của văn bản, hình ảnh, âm thanh hoặc mã nguồn.
Điểm khác biệt so với cơ sở dữ liệu truyền thống nằm ở cách tìm kiếm. Cơ sở dữ liệu truyền thống thường tìm theo giá trị cụ thể như mã sản phẩm, từ khóa hoặc ngày tháng. Vector Database tìm dữ liệu dựa trên mức độ tương đồng về ý nghĩa. Chẳng hạn, khi người dùng tìm “nhẫn vàng đính đá cho ngày cưới” – hệ thống vẫn có thể trả về những sản phẩm phù hợp dù phần mô tả không chứa chính xác cụm từ này.
Một khía cạnh khác khi tìm hiểu Vector Database là gì chính là số chiều của embedding. Mỗi embedding có hàng trăm đến hàng nghìn chiều. Ví dụ, mô hình Amazon Titan Text Embeddings V2 trên Amazon Bedrock tạo ra vector 1.024 chiều theo mặc định, có thể giảm xuống 512 hoặc 256 chiều. Với hàng triệu bản ghi, mỗi bản ghi là một dãy 1.024 số thực – việc so sánh từng cặp vector theo cách thông thường không khả thi về tốc độ. Vector Database tồn tại để giải quyết đúng bài toán này.
Vì sao cơ sở dữ liệu truyền thống chưa đáp ứng tốt nhu cầu của AI?
MySQL hay PostgreSQL xử lý tốt giao dịch, báo cáo và truy vấn dữ liệu có cấu trúc. Tuy nhiên, khi ứng dụng AI cần tìm kiếm theo ngữ nghĩa hoặc xử lý dữ liệu phi cấu trúc, các hệ thống này vẫn có một số hạn chế sau:
- Khó tìm kiếm theo ngữ nghĩa: Truy vấn “làm sao để hoàn tiền” có thể bỏ sót tài liệu mang tiêu đề “chính sách trả hàng” nếu tìm kiếm chỉ dựa trên từ khóa.
- Chưa tối ưu cho tìm kiếm vector: Chỉ mục B-tree phù hợp với các giá trị như số, chuỗi và ngày tháng, nhưng không được thiết kế cho phép tìm kiếm vector nhiều chiều.
- Khó xử lý dữ liệu phi cấu trúc: Email, hợp đồng, hình ảnh sản phẩm và bản ghi cuộc gọi cần được xử lý thành embedding trước khi có thể phục vụ tìm kiếm ngữ nghĩa.
Một số hệ quản trị cơ sở dữ liệu quan hệ đã hỗ trợ tìm kiếm vector thông qua extension như pgvector của PostgreSQL. Phần tiếp theo sẽ phân tích khi nào giải pháp này đáp ứng đủ nhu cầu và khi nào doanh nghiệp nên cân nhắc cơ sở dữ liệu vector chuyên dụng.
Vector Database hoạt động như thế nào?
Sau khi nắm rõ Vector Database là gì, bước tiếp theo là hiểu cách nó vận hành. Vector Database thực hiện tìm kiếm qua 4 bước – từ chuyển đổi dữ liệu thành vector đến truy xuất và lọc kết quả phù hợp.
Bước 1: Tạo embedding
Dữ liệu nguồn (tài liệu, ảnh, mô tả sản phẩm) được đưa qua một mô hình embedding. Với văn bản dài, tài liệu thường được cắt thành các đoạn (chunk) theo đoạn văn hoặc mục, mỗi đoạn tạo ra một vector riêng.
Bước 2: Lưu trữ và đánh chỉ mục
Vector được lưu cùng metadata (tên tài liệu, ngày tạo, phòng ban, mã sản phẩm).Vector Database xây dựng chỉ mục để tìm kiếm nhanh các vector tương đồng (Approximate Nearest Neighbor – viết tắt ANN). Một thuật toán phổ biến là HNSW, sử dụng đồ thị nhiều tầng để thu hẹp phạm vi tìm kiếm thay vì so sánh lần lượt với toàn bộ vector.
Bước 3: Truy vấn
Câu hỏi của người dùng được chuyển thành vector bằng mô hình embedding tương ứng. Vector Database so sánh vector truy vấn với dữ liệu đã lưu, sau đó trả về kết quả gần nhất theo các thước đo như cosine similarity hoặc khoảng cách Euclid.
Bước 4: Lọc và kết hợp
Hệ thống có thể lọc kết quả theo metadata, chẳng hạn chỉ lấy tài liệu năm 2026 hoặc sản phẩm còn hàng. Khi cần kết hợp tìm kiếm theo ngữ nghĩa với tìm kiếm từ khóa – hệ thống sử dụng hybrid search để cải thiện khả năng truy xuất trong các trường hợp mà một phương pháp riêng lẻ chưa đáp ứng tốt.
Với thuật toán ANN, Vector Database ưu tiên tốc độ tìm kiếm bằng cách chấp nhận khả năng bỏ sót một số kết quả phù hợp. Recall là chỉ số đo tỷ lệ kết quả liên quan được tìm thấy trong tổng số kết quả liên quan cần tìm. Khi triển khai, đội ngũ kỹ thuật cần cân chỉnh recall và tốc độ truy vấn theo yêu cầu của từng ứng dụng.
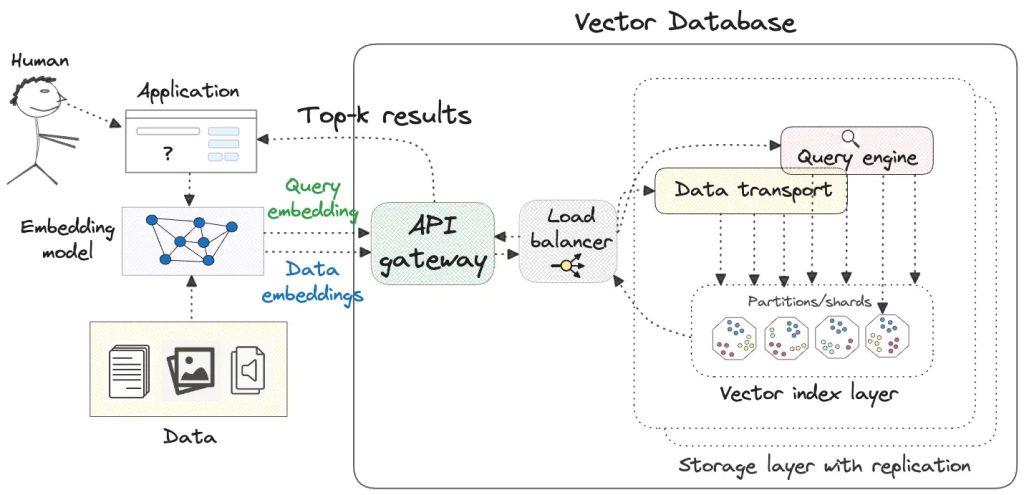
Cách hoạt động của Vector Database
5 Ứng dụng phổ biến của cơ sở dữ liệu vector trong AI
RAG (Retrieval-Augmented Generation)
RAG kết hợp LLM với dữ liệu riêng của doanh nghiệp để tạo câu trả lời sát với thông tin thực tế. Trước khi phản hồi, hệ thống tìm các đoạn tài liệu liên quan trong Vector Database, sau đó đưa chúng vào prompt để LLM sử dụng làm căn cứ trả lời.
Tìm kiếm ngữ nghĩa và tìm kiếm bằng hình ảnh
Vector Database giúp hệ thống tìm kết quả theo ý nghĩa của truy vấn thay vì chỉ so khớp từ khóa. Người dùng có thể mô tả sản phẩm bằng ngôn ngữ tự nhiên hoặc tải ảnh lên để tìm những mặt hàng tương tự.
Renova Cloud đã triển khai Search Intent và Visual Search cho PNJ trên AWS, cho phép khách hàng tìm trang sức bằng mô tả văn bản và hình ảnh nhanh, dễ dàng hơn.
Gợi ý sản phẩm và nội dung
Hệ thống chuyển thông tin sản phẩm, bài viết và lịch sử tương tác của người dùng thành vector. Dựa trên độ tương đồng giữa các vector, hệ thống đề xuất sản phẩm hoặc nội dung phù hợp với sở thích và nhu cầu của từng người.
Phát hiện bất thường
Vector Database hỗ trợ so sánh dữ liệu mới với các nhóm dữ liệu đã ghi nhận. Những giao dịch hoặc sự kiện có đặc điểm khác biệt đáng kể so với hoạt động thông thường có thể được đưa vào danh sách cần kiểm tra, phục vụ phát hiện gian lận và giám sát hệ thống.
Lưu trữ và truy xuất bộ nhớ cho AI agent
Vector Database giúp AI agent ghi nhớ thông tin từ các phiên làm việc trước. Khi cần, agent truy xuất những nội dung liên quan đến yêu cầu hiện tại để tiếp tục xử lý công việc, duy trì ngữ cảnh và hạn chế việc người dùng phải cung cấp lại thông tin.
Các dịch vụ hỗ trợ Vector Database trên AWS
AWS cung cấp nhiều dịch vụ hỗ trợ lưu trữ và tìm kiếm vector. Việc lựa chọn phụ thuộc vào độ trễ yêu cầu, quy mô dữ liệu và khả năng vận hành của đội ngũ.
Amazon OpenSearch Service
Phù hợp với hệ thống RAG trong môi trường production cần kết hợp tìm kiếm vector và tìm kiếm từ khóa. Doanh nghiệp có thể chọn cụm managed để chủ động cấu hình hoặc OpenSearch Serverless để giảm công sức quản lý dung lượng.
Amazon Aurora PostgreSQL và RDS for PostgreSQL với pgvector
Phù hợp với doanh nghiệp đang sử dụng PostgreSQL và muốn bổ sung tìm kiếm vector trên hệ thống hiện có. Dữ liệu quan hệ và vector được lưu trữ chung, truy vấn bằng SQL quen thuộc. Với dữ liệu lớn, đội ngũ cần có kinh nghiệm tối ưu hiệu năng và cấu hình chỉ mục.
Amazon S3 Vectors
Phù hợp với nhu cầu lưu trữ và truy vấn lượng lớn vector khi không yêu cầu độ trễ thấp. Theo công bố của AWS, dịch vụ có thể giảm tới 90% tổng chi phí tải lên, lưu trữ và truy vấn vector, hỗ trợ tới 2 tỷ vector mỗi chỉ mục và 10.000 chỉ mục mỗi bucket. Doanh nghiệp có thể lưu phần lớn vector trên S3 Vectors và sử dụng OpenSearch cho dữ liệu cần truy cập thường xuyên.
Amazon Bedrock Knowledge Bases
Phù hợp với đội ngũ muốn triển khai RAG nhanh mà không phải tự xây dựng toàn bộ quy trình xử lý dữ liệu. Dịch vụ hỗ trợ chia nhỏ tài liệu, tạo embedding, lưu trữ vector và truy xuất thông tin để cung cấp ngữ cảnh cho LLM.
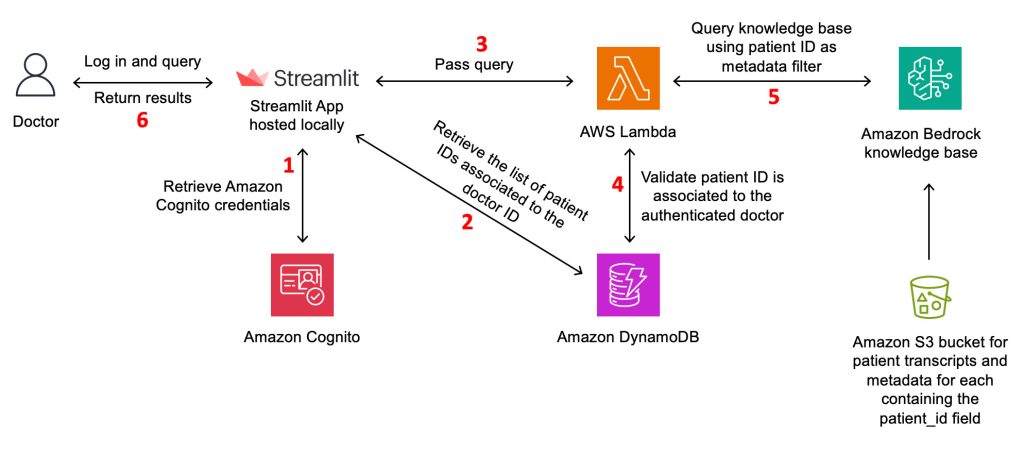
Cách Amazon Bedrock Knowledge Bases hỗ trợ Vector Database
Các lựa chọn khác trên AWS
Tùy yêu cầu kỹ thuật, doanh nghiệp có thể cân nhắc Amazon Neptune Analytics cho truy vấn kết hợp đồ thị và vector, Amazon MemoryDB cho tìm kiếm vector trong bộ nhớ, hoặc các giải pháp từ Pinecone, MongoDB Atlas và Redis thông qua AWS Marketplace.
Cách chọn Vector Database phù hợp cho dự án AI trên AWS
Hiểu Vector Database là gì mới là bước đầu, để chọn Vector Database, doanh nghiệp cần xem xét năm yếu tố: độ trễ, quy mô dữ liệu, khả năng tìm kiếm, tần suất cập nhật và năng lực vận hành của đội ngũ.
5 câu hỏi cần trả lời trước khi chọn Vector Database
Hệ thống cần phản hồi nhanh đến mức nào?
Ứng dụng gợi ý sản phẩm theo thời gian thực cần độ trễ thấp hơn chatbot hỏi đáp tài liệu nội bộ. Hãy xác định thời gian phản hồi mục tiêu để thu hẹp danh sách giải pháp phù hợp.
Quy mô dữ liệu hiện tại và dự kiến sau 18 tháng là bao nhiêu?
Với dữ liệu dưới vài triệu vector, pgvector có thể đáp ứng tốt. Khi quy mô tăng lên hàng chục triệu hoặc hàng tỷ vector, doanh nghiệp nên đánh giá Amazon OpenSearch Service hoặc kiến trúc lưu trữ phân tầng sử dụng Amazon S3 Vectors.
Ứng dụng có cần lọc metadata và tìm kiếm từ khóa không?
Nhiều ứng dụng doanh nghiệp cần kết hợp tìm kiếm ngữ nghĩa, lọc theo thuộc tính và tìm kiếm từ khóa. Hãy kiểm tra khả năng hybrid search của từng giải pháp để bảo đảm kết quả phù hợp với nhu cầu thực tế.
Dữ liệu thay đổi thường xuyên đến mức nào?
Nếu tài liệu được cập nhật hàng ngày, hệ thống cần hỗ trợ thêm, sửa và xóa vector hiệu quả. Khả năng cập nhật chỉ mục sẽ ảnh hưởng đến thời gian xử lý và độ mới của kết quả tìm kiếm.
Đội ngũ có thể vận hành công nghệ nào?
Nếu đã sử dụng PostgreSQL, đội ngũ có thể triển khai pgvector thuận lợi hơn so với việc làm quen Amazon OpenSearch Service từ đầu. Khi so sánh các phương án, hãy tính cả thời gian quản trị, giám sát và xử lý sự cố, thay vì chỉ xét chi phí hạ tầng.
Giảm chi phí lưu trữ bằng cách chọn số chiều vector phù hợp
Số chiều vector ảnh hưởng trực tiếp đến dung lượng lưu trữ và hiệu suất tìm kiếm. Với Titan Text Embeddings V2, giảm từ 1.024 xuống 512 chiều vẫn giữ khoảng 99% độ chính xác truy xuất, xuống 256 chiều giữ 97%. Kết quả thực tế phụ thuộc vào dữ liệu và cách đánh giá của từng ứng dụng.
Doanh nghiệp nên thử nghiệm các mức số chiều trên bộ dữ liệu thực tế trước khi triển khai rộng. Cách này giúp cân đối chất lượng truy xuất, tốc độ và chi phí khi lượng dữ liệu tăng lên.
Chọn Vector Database nào cho dự án AI trên AWS?
Tóm lại, nếu hỏi Vector Database là gì, câu trả lời ngắn gọn là: Vector Database cho phép ứng dụng tìm kiếm thông tin dựa trên ý nghĩa của nội dung. Công nghệ này thường được sử dụng trong RAG, tìm kiếm ngữ nghĩa, gợi ý sản phẩm và bộ nhớ cho AI agent.
Trên AWS, doanh nghiệp có thể cân nhắc các lựa chọn sau:
- pgvector: Phù hợp với dự án đã sử dụng PostgreSQL và có quy mô dữ liệu vừa phải.
- Amazon OpenSearch Service: Phù hợp với hệ thống tìm kiếm cần mở rộng, kết hợp vector search với tìm kiếm từ khóa và bộ lọc.
- Amazon S3 Vectors: Phù hợp với nhu cầu lưu trữ và truy vấn vector quy mô lớn, ưu tiên tối ưu chi phí.
- Amazon Bedrock Knowledge Bases: Phù hợp với doanh nghiệp muốn xây dựng ứng dụng RAG mà không phải tự triển khai toàn bộ quy trình xử lý dữ liệu và truy xuất.
Mỗi giải pháp có giới hạn và chi phí vận hành riêng. Doanh nghiệp nên kiểm thử bằng dữ liệu thực tế để đánh giá độ trễ, chất lượng tìm kiếm, khả năng mở rộng và tổng chi phí sở hữu trước khi quyết định.
Tư vấn kiến trúc Vector Database cùng Renova Cloud
Chọn sai Vector Database có thể khiến hệ thống phát sinh chi phí cao hoặc không đáp ứng được yêu cầu hiệu suất khi lượng dữ liệu tăng. Vì vậy, doanh nghiệp cần đánh giá giải pháp dựa trên nhu cầu hiện tại và kế hoạch mở rộng trong tương lai.
Là AWS Partner of the Year Việt Nam năm 2023, 2024 và 2026 với năng lực AI Services Competency – Renova Cloud đã triển khai các giải pháp tìm kiếm ngữ nghĩa và Generative AI cho PNJ, ACBS cùng nhiều doanh nghiệp khác.
Nếu bạn đang xây dựng ứng dụng AI trên AWS, liên hệ ngay đội ngũ Renova Cloud để được tư vấn lựa chọn Vector Database phù hợp với dữ liệu, ngân sách và lộ trình của doanh nghiệp.
Câu hỏi thường gặp về Vector Database
Vector Database có thay thế cơ sở dữ liệu quan hệ không?
Không. Cơ sở dữ liệu quan hệ phù hợp với dữ liệu có cấu trúc, giao dịch và báo cáo. Vector Database phục vụ tìm kiếm theo ngữ nghĩa trên dữ liệu như văn bản, hình ảnh và tài liệu. Doanh nghiệp có thể sử dụng song song hai hệ thống hoặc tích hợp tìm kiếm vector vào PostgreSQL bằng extension như pgvector.
Embedding và Vector Database khác nhau thế nào?
Embedding là dãy số do mô hình AI tạo ra để biểu diễn đặc điểm ngữ nghĩa của dữ liệu. Vector Database lưu trữ các vector này và tìm kiếm những vector tương đồng. Nói đơn giản, embedding là dữ liệu cần tìm kiếm, còn Vector Database là hệ thống thực hiện việc đó.
Có cần Vector Database để sử dụng LLM không?
Không bắt buộc. Nếu chỉ sử dụng kiến thức có sẵn của mô hình, bạn có thể gọi LLM trực tiếp. Khi muốn mô hình trả lời dựa trên tài liệu nội bộ hoặc dữ liệu riêng của doanh nghiệp, bạn có thể triển khai RAG và sử dụng Vector Database để truy xuất thông tin liên quan.
Doanh nghiệp nhỏ nên bắt đầu từ đâu?
Bắt đầu với Amazon Bedrock Knowledge Bases hoặc pgvector trên cơ sở dữ liệu PostgreSQL đang có. Cả hai đều cho phép kiểm chứng giá trị của ứng dụng trước khi đầu tư vào hệ thống chuyên biệt.