 Dịch vụ
 Công nghệ
 Về Renova
 Khách hàng


ETL là gì? Quy trình Extract-Transform-Load và công cụ ETL trên AWS
Chia sẻ bài viết


Mục lục
Một doanh nghiệp bán lẻ có dữ liệu đơn hàng từ POS, dữ liệu khách hàng từ CRM, dữ liệu tồn kho từ hệ thống của nhà cung cấp và dữ liệu quảng cáo trên nhiều nền tảng. Mỗi nguồn lại dùng định dạng, tên trường và tần suất cập nhật khác nhau, khiến việc tổng hợp dữ liệu để tìm ra nhóm khách hàng mang lại lợi nhuận cao nhất trở nên khá phức tạp.
ETL giúp kết nối và chuẩn hóa những nguồn dữ liệu này thông qua ba bước: Extract, Transform và Load. Cùng tìm hiểu ETL là gì, quy trình hoạt động ra sao, khác ELT và zero-ETL ở điểm nào, và những công cụ ETL phổ biến trên AWS qua những chia sẻ từ Renova Cloud.
ETL là gì?
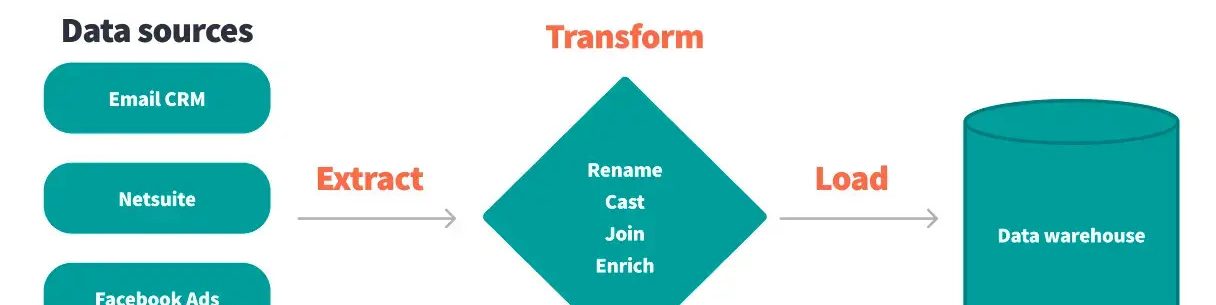
ETL là viết tắt của Extract – Transform – Load, tức Trích xuất – Chuyển đổi – Tải dữ liệu. Theo AWS: ETL là quy trình tập hợp dữ liệu từ nhiều nguồn về một nơi lưu trữ tập trung như data warehouse. Sau đó áp dụng các quy tắc nghiệp vụ để làm sạch, chuẩn hóa và sắp xếp dữ liệu trước khi đưa vào phân tích hoặc machine learning.
Hiểu đơn giản, ETL không phải là “chuyển file từ A sang B”. Phần tạo ra giá trị nằm ở bước Transform – nơi dữ liệu thô được xử lý để các hệ thống khác nhau có thể sử dụng chung một chuẩn dữ liệu.
ETL mang lại nhiều lợi ích cho hoạt động phân tích. Dữ liệu từ các hệ thống cũ có thể được kết hợp với dữ liệu mới để duy trì bối cảnh lịch sử. Thông tin từ nhiều nguồn cũng được gom thành một góc nhìn thống nhất, giúp kết quả phân tích chính xác và đáng tin cậy hơn, đồng thời hỗ trợ các yêu cầu về tuân thủ.
Với đội ngũ kỹ thuật, một lợi ích rất thực tế là tự động hóa những công việc xử lý dữ liệu lặp đi lặp lại. Thay vì mất thời gian kiểm tra, làm sạch và chuyển dữ liệu thủ công – đội ngũ có thể dành nhiều thời gian hơn cho những công việc tạo ra giá trị.
ETL hoạt động như thế nào?
Bước 1: Extract – Trích xuất
Dữ liệu thô được lấy từ các hệ thống nguồn và đưa vào staging area – nơi lưu trữ tạm thời trước khi xử lý. Sau khi hoàn tất, dữ liệu tại đây thường được xóa, dù doanh nghiệp có thể giữ lại bản sao để xử lý sự cố khi cần.
Cách trích xuất phụ thuộc vào khả năng của hệ thống nguồn. AWS đề cập ba phương án phổ biến:
- Update notification: Hệ thống nguồn chủ động thông báo khi có dữ liệu thay đổi.
- Incremental extraction: Xác định phần dữ liệu mới hoặc đã thay đổi trong một khoảng thời gian và chỉ trích xuất phần đó.
- Full extraction: Lấy lại toàn bộ dữ liệu khi hệ thống không thể xác định phần thay đổi. Cách này tạo ra lượng dữ liệu truyền tải lớn, nên phù hợp hơn với các bảng nhỏ.
Việc chọn sai phương pháp có thể khiến chi phí xử lý tăng mạnh. Chẳng hạn, nếu mỗi đêm đều quét lại toàn bộ bảng trong khi chỉ 2% dữ liệu thay đổi, phần lớn tài nguyên đang bị dùng cho những dữ liệu không cần xử lý lại.
Bước 2: Transform – Chuyển đổi
Đây thường là bước có nhiều logic nghiệp vụ nhất. Dữ liệu sau khi trích xuất được làm sạch, chuẩn hóa và điều chỉnh để phù hợp với hệ thống đích.
Các thao tác cơ bản gồm: chuẩn hóa định dạng, xử lý giá trị trống, loại bỏ bản ghi trùng lặp và thống nhất đơn vị đo lường. Ví dụ, một doanh nghiệp thực phẩm có thể lưu công thức ở nhiều cơ sở dữ liệu khác nhau, nơi dùng kilogram, nơi dùng pound. ETL sẽ chuyển chúng về cùng một đơn vị để dữ liệu có thể phân tích thống nhất. AWS.
Ở mức nâng cao, pipeline có thể áp dụng thêm các quy tắc nghiệp vụ như:
- Derivation: Tính toán giá trị mới từ dữ liệu hiện có.
- Joining: Kết hợp dữ liệu tương ứng từ nhiều nguồn.
- Splitting: Tách một cột thành nhiều cột.
- Summarization: Tổng hợp dữ liệu thành các chỉ số như customer lifetime value.
- Data masking/encryption: Mã hóa dữ liệu nhạy cảm trước khi đưa sang hệ thống đích.
Với doanh nghiệp Việt Nam, bảo vệ dữ liệu nhạy cảm nên được tính ngay từ khâu thiết kế pipeline. Làm từ đầu sẽ dễ kiểm soát hơn nhiều so với việc bổ sung cơ chế bảo mật sau khi hệ thống đã vận hành.
Bước 3: Load – Tải dữ liệu
Sau khi được xử lý, dữ liệu sẽ được đưa vào hệ thống đích như data warehouse hoặc data lake. Có hai phương thức tải phổ biến:
- Full load: Chuyển toàn bộ dữ liệu nguồn sang hệ thống đích, thường được sử dụng trong lần nạp dữ liệu đầu tiên.
- Incremental load: Chỉ cập nhật phần dữ liệu mới hoặc đã thay đổi kể từ lần tải trước, giúp giảm thời gian xử lý và lượng dữ liệu phải truyền tải.
Incremental load thường được triển khai theo hai cách:
- Streaming cập nhật dữ liệu liên tục và phù hợp với các luồng dữ liệu cần phản ánh gần như theo thời gian thực.
- Batch gom dữ liệu thành từng đợt rồi xử lý theo chu kỳ, phù hợp với khối lượng dữ liệu lớn và những hệ thống không yêu cầu cập nhật tức thời.
ETL hoạt động theo 3 bước: Trích xuất → Chuyển đổi → Tải dữ liệu
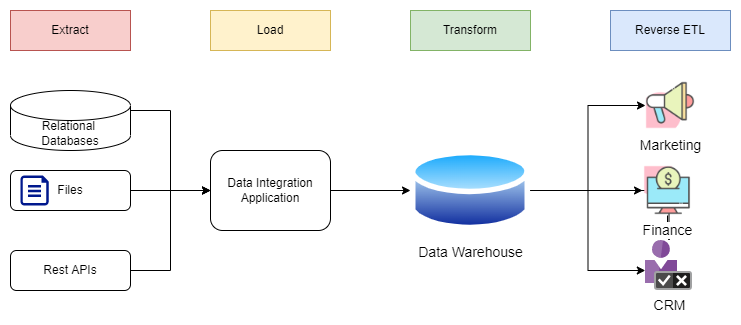
ETL, ELT và zero-ETL khác nhau ở đâu?
Điểm khác nhau nằm ở cách dữ liệu được đưa vào hệ thống đích và xử lý ở bước nào.
- Với ETL, dữ liệu được trích xuất, biến đổi rồi mới nạp vào hệ thống đích. Cách này phù hợp khi dữ liệu cần được chuẩn hóa, kiểm tra cấu trúc và áp dụng quy tắc nghiệp vụ trước khi đưa vào kho dữ liệu.
- Với ELT (Extract, Load, Transform), thứ tự được đảo lại. Dữ liệu được nạp thẳng vào hệ thống đích rồi mới xử lý. Nhờ tận dụng năng lực tính toán của các nền tảng dữ liệu hiện đại, ELT phù hợp với khối lượng dữ liệu lớn, dữ liệu phi cấu trúc và các trường hợp cần nạp dữ liệu thường xuyên. So với ETL, cách tiếp cận này cũng giảm bớt yêu cầu xử lý dữ liệu ở giai đoạn đầu.
- Zero-ETL là bước tiến xa hơn khi nhiều công đoạn tích hợp dữ liệu được nền tảng tự động quản lý. Zero-ETL giúp giảm nhu cầu tự xây dựng và duy trì pipeline ETL cho các nhu cầu sao chép, đồng bộ dữ liệu phổ biến, đưa dữ liệu từ nhiều nguồn giao dịch, vận hành và ứng dụng vào Amazon SageMaker Lakehouse hoặc Amazon Redshift.
Trong thực tế, zero-ETL cho phép dữ liệu từ Amazon Aurora được đưa sang Amazon Redshift hoặc lakehouse gần như theo thời gian thực, trong khi hệ thống tự theo dõi trạng thái của luồng dữ liệu. AWS cũng mở rộng zero-ETL cho nhiều ứng dụng SaaS như Salesforce, SAP, ServiceNow và Zendesk, cùng các cơ sở dữ liệu như Oracle, SQL Server, MySQL và PostgreSQL thông qua AWS Glue.
Có thể hiểu đơn giản:
- ETL: Xử lý dữ liệu trước → nạp vào kho.
- ELT: Nạp dữ liệu trước → xử lý trong kho.
- Zero-ETL: Nền tảng tự lo phần lớn việc đồng bộ dữ liệu giữa các hệ thống.
Nếu nhu cầu chỉ là đồng bộ dữ liệu từ hệ thống giao dịch sang kho phân tích và giữ dữ liệu luôn cập nhật, zero-ETL có thể giúp giảm đáng kể công sức xây dựng và vận hành pipeline. Khi cần biến đổi dữ liệu theo logic nghiệp vụ phức tạp, ETL hoặc ELT vẫn là lựa chọn phù hợp hơn.
Bộ công cụ ETL trên AWS
AWS Glue: trung tâm của hệ sinh thái ETL
AWS Glue là dịch vụ tích hợp dữ liệu serverless, giúp kết nối dữ liệu từ hơn 100 nguồn, quản lý metadata tập trung và xây dựng, chạy, theo dõi pipeline mà không cần tự vận hành hạ tầng. Với Glue Studio – người dùng có thể chọn Visual ETL, notebook hoặc trình soạn thảo code, tùy theo nhu cầu của kỹ sư dữ liệu hay nhóm nghiệp vụ.
Về runtime, AWS Glue 5.1 ra mắt ngày 26/11/2025, sử dụng Apache Spark 3.5.6, Python 3.11 và Scala 2.12.18. Phiên bản này cũng cập nhật Apache Hudi 1.0.2, Apache Iceberg 1.10.0 và Delta Lake 3.3.2.
Glue 5.1 hỗ trợ Iceberg format v3 với deletion vector cho bảng merge-on-read, theo dõi row lineage và mở rộng quyền kiểm soát chi tiết của AWS Lake Formation sang cả thao tác ghi. Trước đó, Glue 5.0 là phiên bản đầu tiên hỗ trợ Amazon SageMaker Unified Studio và SageMaker Lakehouse.
Nếu hệ thống vẫn đang chạy Glue 4.0 hoặc cũ hơn, đây là thời điểm hợp lý để đánh giá kế hoạch nâng cấp.
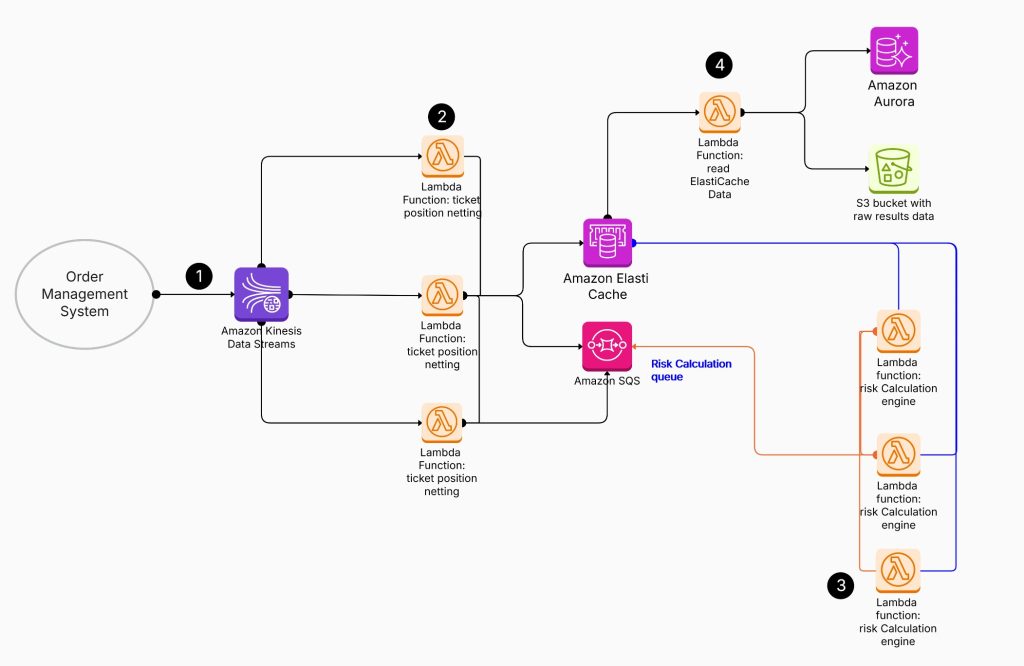
AWS Glue giúp doanh nghiệp đơn giản hóa toàn bộ quy trình tích hợp và xử lý dữ liệu trên nền tảng AWS
Amazon EMR, AWS DMS và các dịch vụ điều phối
AWS Glue phù hợp với nhiều pipeline ETL, nhưng không phải workload nào cũng nên đưa vào Glue.
- Amazon EMR phù hợp với những đội ngũ cần kiểm soát sâu môi trường Hadoop hoặc Spark, từ cấu hình cụm, tham số xử lý đến vòng đời cluster. Đổi lại, đội ngũ sẽ phải đảm nhận nhiều phần vận hành hơn so với Glue.
- AWS DMS phù hợp với nhu cầu di chuyển và đồng bộ cơ sở dữ liệu. Khi cần Change Data Capture (CDC) liên tục từ hệ thống on-premises, DMS thường là lựa chọn thực tế hơn một pipeline ETL truyền thống.
- AWS Step Functions và Amazon MWAA đảm nhiệm phần điều phối: xâu chuỗi các job, xử lý lỗi, retry, thông báo. Đây cũng là những hướng AWS đề xuất khi chuyển khỏi AWS Data Pipeline, tùy vào đặc điểm workload.
Có một điểm cần tránh khi tham khảo các tài liệu AWS cũ. AWS Data Pipeline đã ngừng tiếp nhận khách hàng mới từ ngày 25/07/2024. Khách hàng hiện tại vẫn có thể sử dụng dịch vụ, nhưng AWS không bổ sung tính năng mới. Vì vậy, nếu triển khai một dự án mới, Data Pipeline không còn là lựa chọn phù hợp.
Tương tự, AWS Glue for Ray đã ngừng tiếp nhận khách hàng mới từ ngày 30/04/2026 – và AWS gợi ý tham khảo Amazon EKS cho các nhu cầu tương đương.
Cách chọn công cụ phù hợp với từng tình huống
Thay vì chọn theo độ phổ biến, hãy nhìn vào đặc điểm của bài toán dữ liệu để xác định công cụ phù hợp:
- Cần đưa dữ liệu giao dịch sang kho phân tích, gần thời gian thực, ít biến đổi logic → cân nhắc zero-ETL trước tiên.
- Cần biến đổi phức tạp, nhiều nguồn, chạy theo lịch → AWS Glue với Spark job hoặc Visual ETL.
- Cần kiểm soát sâu về hiệu năng và cấu hình cụm, workload lớn và ổn định → Amazon EMR.
- Cần di chuyển hoặc đồng bộ cơ sở dữ liệu liên tục → AWS DMS.
- Cần xâu chuỗi nhiều job của nhiều dịch vụ, có xử lý lỗi và điều kiện → Step Functions hoặc Amazon MWAA.
Trong thực tế, các công cụ này thường bổ trợ cho nhau thay vì hoạt động độc lập. Một kiến trúc có thể dùng zero-ETL cho luồng sao chép dữ liệu, Glue để xử lý biến đổi và Step Functions để điều phối toàn bộ pipeline.
>> Khám phá thêm Dịch vụ Data Integration & AWS Glue Migration, Data Platforms & Analytics hoặc Data Migration là gì để có thêm góc nhìn trước khi bắt đầu dự án.
Triển khai nền tảng dữ liệu trên AWS cùng Renova Cloud
Một pipeline chạy ổn hôm nay chưa chắc sẽ vận hành trơn tru trong vài năm tới. Với nền tảng dữ liệu, sự khác biệt nằm ở cách thiết kế ngay từ đầu: phân vùng dữ liệu hợp lý, nạp dữ liệu gia tăng, phân quyền truy cập, theo dõi chi phí và có phương án xử lý khi job gặp lỗi ngoài giờ.
Renova Cloud là AWS Premier Consulting Partner – Đối tác tư vấn Cao cấp của AWS, được vinh danh AWS Partner of the Year Việt Nam năm 2023, 2024 và 2026, đồng thời sở hữu AWS Service Delivery Designation cho AWS Glue và AWS AI Services Competency. Với kinh nghiệm triển khai cho doanh nghiệp trong lĩnh vực tài chính, sản xuất, chuỗi cung ứng và bán lẻ – đội ngũ Renova Cloud có thể đồng hành từ khâu thiết kế đến vận hành nền tảng dữ liệu trên AWS.
Liên hệ ngay với Renova Cloud để nhận buổi trao đổi miễn phí về kiến trúc nền tảng dữ liệu trên AWS cho doanh nghiệp của bạn.
Câu hỏi thường gặp
Nên chọn ETL hay ELT?
Tùy vào cách doanh nghiệp muốn xử lý dữ liệu.
- ELT phù hợp với dữ liệu lớn, phi cấu trúc và cần nạp thường xuyên, vì phần biến đổi được thực hiện sau khi dữ liệu đã vào kho.
- ETL phù hợp khi dữ liệu cần được làm sạch, chuẩn hóa và xác định cấu trúc trước khi lưu trữ.
Doanh nghiệp nhỏ có cần ETL không?
Có, đặc biệt khi dữ liệu đã nằm trên nhiều hệ thống và việc tổng hợp báo cáo bằng Excel bắt đầu tốn thời gian. Với quy mô nhỏ, doanh nghiệp có thể dùng các dịch vụ serverless, tính phí theo thời gian chạy thay vì phải duy trì hạ tầng xử lý riêng.
Zero-ETL có thay thế hoàn toàn ETL không?
Không. Zero-ETL giúp đơn giản hóa việc nạp và đồng bộ dữ liệu trong một số trường hợp phổ biến. Khi cần làm sạch, chuẩn hóa dữ liệu hoặc tính toán các chỉ số theo yêu cầu nghiệp vụ, pipeline ETL/ELT vẫn rất cần thiết.
Mất bao lâu để dựng pipeline ETL đầu tiên trên AWS?
Một pipeline đơn giản từ S3 qua Glue rồi truy vấn bằng Athena có thể hoàn thành trong vòng vài giờ. Phần mất thời gian không nằm ở công cụ, mà ở việc thống nhất định nghĩa dữ liệu giữa các phòng ban.