 Dịch vụ
 Công nghệ
 Về Renova
 Khách hàng


MLOps là gì? Vận hành mô hình Machine Learning từ dev đến production
Chia sẻ bài viết


Mục lục
Một mô hình đạt độ chính xác 94% trên tập test chưa chắc sẽ giữ được kết quả đó khi chạy thực tế. Sau một thời gian, dữ liệu thay đổi có thể khiến hiệu suất giảm, trong khi đội ngũ khó theo dõi phiên bản mô hình đang chạy, thời điểm cần cập nhật hay retrain.
MLOps ra đời để giải quyết những vấn đề này. Đây là cách doanh nghiệp quản lý và vận hành mô hình Machine Learning từ lúc phát triển đến production, với quy trình rõ ràng cho triển khai, giám sát và cập nhật mô hình.
Cùng tìm hiểu MLOps là gì, quy trình này hoạt động như thế nào và vì sao doanh nghiệp cần MLOps khi đưa Machine Learning vào vận hành thực tế.
MLOps là gì?
MLOps (Machine Learning Operations) là tập hợp các phương pháp giúp kết nối quá trình phát triển mô hình Machine Learning với việc đưa mô hình vào vận hành thực tế. Mục tiêu là tự động hóa và kiểm soát xuyên suốt các bước từ phát triển, kiểm thử, triển khai đến giám sát hệ thống ML.
Thực tế, xây được một mô hình ML mới chỉ là bước đầu. Khi đưa vào production, doanh nghiệp còn phải xử lý dữ liệu, hạ tầng, cấu hình, tài nguyên, triển khai và theo dõi hiệu suất mô hình.
Nghiên cứu của Google cho thấy phần mã ML thường chỉ chiếm một phần nhỏ trong toàn bộ hệ thống, trong khi các thành phần xung quanh lại tạo ra phần lớn khối lượng kỹ thuật. Đây cũng là lý do nhiều dự án AI hoạt động tốt ở giai đoạn thử nghiệm nhưng gặp khó khi vận hành ở quy mô thực tế.
MLOps khác DevOps ở đâu?
Hệ thống machine learning vẫn là phần mềm, nên DevOps vẫn là nền tảng cần thiết. Tuy vậy, đặc thù của dữ liệu và mô hình khiến quy trình vận hành MLOps có thêm nhiều lớp kiểm soát.
- Về kiểm thử, ngoài unit test và integration test, MLOps cần kiểm tra chất lượng dữ liệu, schema, mô hình sau huấn luyện và kết quả validation. Một pipeline ML chỉ ổn khi cả code, dữ liệu và mô hình đều đạt yêu cầu.
- Về triển khai, hệ thống thường phải vận hành cả pipeline huấn luyện, từ chuẩn bị dữ liệu, train, đánh giá đến deploy model thành prediction service. Khi có dữ liệu mới hoặc mô hình mới, các bước này có thể được tự động hóa thay vì xử lý thủ công.
Vấn đề ở production cũng khác. Một mô hình có thể hoạt động tốt khi mới triển khai nhưng giảm độ chính xác khi phân phối dữ liệu thay đổi theo thời gian. Đây là một dạng lỗi mà phần mềm truyền thống ít gặp hơn, bởi code có thể vẫn chạy đúng trong khi chất lượng dự đoán đã đi xuống.
Vì vậy, CI/CD trong MLOps được mở rộng để xử lý cả dữ liệu và mô hình. Đặc biệt, MLOps có thêm CT (Continuous Training) để tự động retrain và cập nhật mô hình khi cần. Đây là điểm khác biệt rõ nhất giữa MLOps và DevOps.
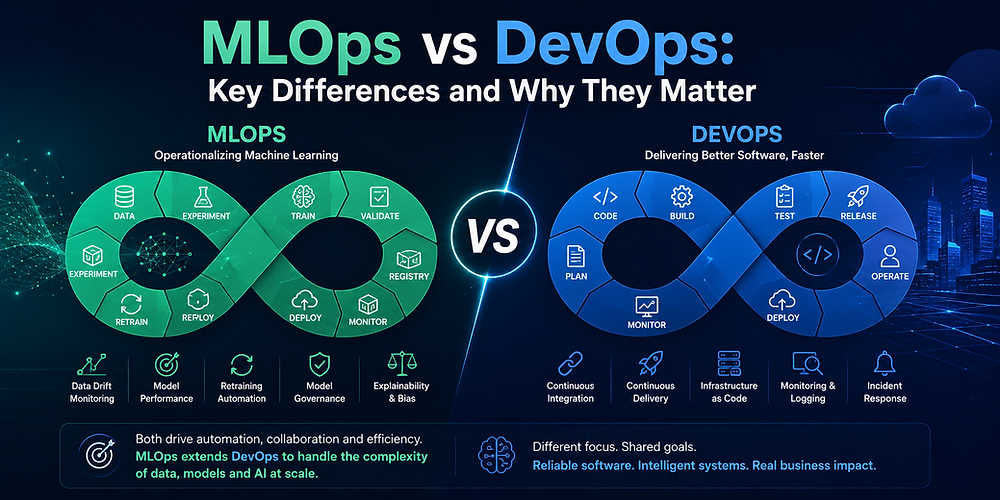
MLOps mở rộng DevOps để quản lý đồng thời code, dữ liệu và mô hình trong suốt vòng đời machine learning
Quy trình đưa mô hình ML từ dev đến production
Sau khi xác định bài toán kinh doanh và tiêu chí đánh giá, một mô hình ML thường đi qua 8 bước trước khi chạy thực tế: trích xuất dữ liệu, EDA, chuẩn bị dữ liệu, huấn luyện, đánh giá, validation, phục vụ và giám sát. Các bước này có thể được thực hiện thủ công hoặc tự động hóa bằng pipeline. Mức độ tự động hóa càng cao, quy trình ML càng dễ vận hành ổn định và mở rộng.
Hai khâu thường bị bỏ ngỏ là model serving và model monitoring. Khi mô hình đã được validate, đội ngũ có thể đưa mô hình vào production dưới dạng microservice với REST API để dự đoán theo thời gian thực, nhúng trực tiếp vào thiết bị edge hoặc mobile, hoặc tích hợp vào hệ thống dự đoán theo lô.
Sau khi triển khai, công việc chưa dừng lại. Model monitoring giúp theo dõi hiệu năng và phát hiện sớm những dấu hiệu suy giảm. Khi chất lượng dự đoán không còn đáp ứng yêu cầu, hệ thống có thể kích hoạt vòng lặp ML tiếp theo để đánh giá, huấn luyện và triển khai phiên bản mới.
3 Cấp độ trưởng thành của MLOps
Google Cloud chia mức độ trưởng thành của MLOps thành ba cấp, dựa trên mức độ tự động hóa trong quá trình xây dựng, triển khai và vận hành mô hình. Thang đo này giúp doanh nghiệp xác định quy trình hiện tại đang ở đâu và nên cải thiện từ bước nào.
Cấp độ 0 – Quy trình thủ công
Ở cấp độ này, gần như mọi công đoạn đều do con người thực hiện. Data scientist phân tích, chuẩn bị dữ liệu, huấn luyện và kiểm thử mô hình thủ công, thường thông qua notebook, cho đến khi có một model có thể sử dụng.
Một số dấu hiệu dễ nhận biết:
- Data scientist bàn giao model đã train cho đội kỹ thuật để triển khai thành API, dễ tạo ra training-serving skew do môi trường huấn luyện và production có sự khác biệt.
- Model mới chỉ được phát hành vài lần mỗi năm.
- Chưa có CI/CD và thiếu cơ chế theo dõi chủ động hiệu năng của model hoặc log các dự đoán trong production.
Cấp độ 0 có thể phù hợp với những model ít thay đổi hoặc hiếm khi cần retrain. Khi dữ liệu và môi trường vận hành biến động thường xuyên, cách làm này dễ khiến model xuống hiệu năng mà đội ngũ không phát hiện kịp thời.
Cấp độ 1 – Tự động hóa ML pipeline
Ở cấp độ 1, mục tiêu là tự động hóa ML pipeline để hỗ trợ continuous training. Thay vì train một model rồi đưa model đó lên production, doanh nghiệp triển khai một pipeline có khả năng chạy lặp lại để tạo ra model mới cho hệ thống dự đoán.
Pipeline thường bổ sung hai lớp kiểm tra quan trọng, gồm:
- Data validation kiểm tra dữ liệu trước khi train, chẳng hạn schema có thay đổi hay các giá trị có biến động bất thường hay không.
- Model validation đánh giá model vừa train và so sánh với model đang chạy để quyết định có nên đưa model mới vào production.
Việc đánh giá cũng nên xem xét hiệu năng trên từng nhóm dữ liệu. Chẳng hạn, một model dự đoán churn có thể đạt điểm tốt trên toàn bộ tập dữ liệu nhưng lại hoạt động kém ở một khu vực hoặc nhóm khách hàng cụ thể.
Pipeline có thể được kích hoạt theo nhiều cách, chẳng hạn chạy theo lịch, có dữ liệu training mới, model giảm hiệu năng hoặc phân phối dữ liệu thay đổi đáng kể.
Cấp độ 2 – Tự động hóa CI/CD cho ML pipeline
Cấp độ 2 đưa tự động hóa lên một bước nữa, tập trung vào việc cập nhật ML pipeline nhanh và ổn định trong production. Data scientist có thể thử nghiệm feature engineering, kiến trúc model hoặc hyperparameter, sau đó các thay đổi được build, test và deploy thông qua quy trình CI/CD.
Một quy trình hoàn chỉnh thường gồm 6 nhóm hoạt động:
- Phát triển và thử nghiệm.
- Continuous Integration cho pipeline.
- Continuous Delivery cho pipeline.
- Tự động kích hoạt pipeline.
- Continuous Delivery cho model.
- Giám sát model và hệ thống.
Dù mức tự động hóa cao hơn, phân tích dữ liệu và phân tích model vẫn cần sự tham gia của data scientist. MLOps không thay thế quyết định chuyên môn của con người, mà chỉ giảm bớt những công việc lặp lại để đội ngũ tập trung vào các vấn đề cần đánh giá và thử nghiệm.
Doanh nghiệp cũng không cần nâng cấp toàn bộ quy trình lên cấp độ 2 ngay lập tức. Có thể bắt đầu từ những bước nhỏ như validation, automation cho training hoặc CI/CD, sau đó mở rộng dần khi đội ngũ và hệ thống đã sẵn sàng.
Cách triển khai MLOps trên AWS hiệu quả
AWS đưa MLOps vào Machine Learning Lens của Well-Architected Framework và đánh giá rủi ro ở mức Cao nếu doanh nghiệp không có các thực hành MLOps phù hợp. Một số vấn đề thường gặp là deploy model lên production thủ công, dùng quy trình khác nhau giữa dev và production, không version hóa hạ tầng, cấu hình và model artifact, thiếu kiểm thử tự động hoặc viết script dùng một lần thay vì xây dựng template có thể tái sử dụng.
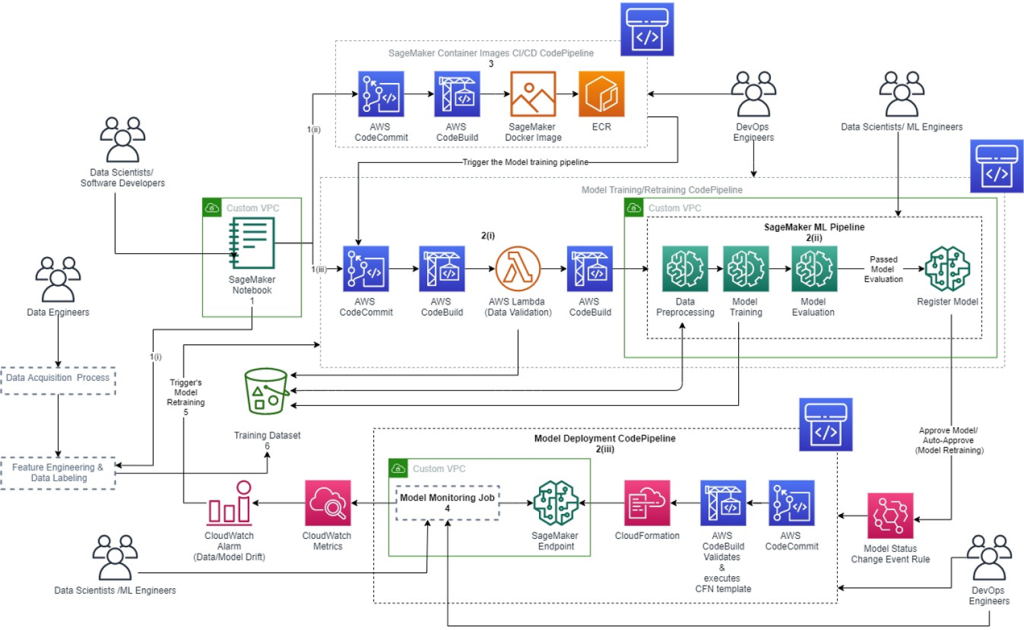
Để tránh những điểm yếu này, AWS đề xuất một quy trình triển khai MLOps chuẩn như sau:
- Orchestration:
Amazon SageMaker AI Pipelines cho phép xây dựng workflow ML bằng Python SDK, tự động ghi lại các bước thực hiện để dễ theo dõi và audit dữ liệu, cấu hình và tham số huấn luyện.
Với workflow phức tạp hơn hoặc cần kết nối với các dịch vụ bên ngoài SageMaker, doanh nghiệp có thể cân nhắc AWS Step Functions Data Science SDK hoặc Amazon MWAA.
- Hạ tầng dạng mã:
AWS CloudFormation và AWS CDK giúp chuẩn hóa cách xây dựng và quản lý hạ tầng. CDK có thể phù hợp với những đội ngũ đã quen với Python, TypeScript hoặc Java.
- CI/CD và model registry:
AWS CodePipeline có thể kết hợp các bước kiểm thử tự động về chất lượng dữ liệu, hiệu năng model và chức năng API. Model mới nên được đưa qua staging trước production, kèm bước phê duyệt nếu quy trình yêu cầu kiểm soát thủ công. SageMaker AI Model Registry giúp quản lý các phiên bản model trong suốt vòng đời triển khai.
- Giám sát:
SageMaker AI Model Monitor theo dõi chất lượng dữ liệu, chất lượng model, bias drift và feature attribution drift. Amazon CloudWatch có thể được dùng để xây dựng dashboard, theo dõi chỉ số và gửi cảnh báo khi có bất thường.
- Rollback:
Pipeline nên có cơ chế quay lại phiên bản trước khi model mới không đạt ngưỡng chất lượng. Với các hệ thống cần giảm rủi ro khi phát hành, có thể sử dụng chiến lược canary hoặc blue/green thông qua AWS CodeDeploy để chuyển traffic từng bước.
- Bảo mật và governance:
Dùng IAM để kiểm soát truy cập, CloudTrail để ghi log API phục vụ audit, và SageMaker AI Model Cards để ghi lại thông tin mô hình, mục đích sử dụng, giới hạn và đặc tính hiệu năng
Với doanh nghiệp Việt Nam, bài toán khó thường nằm ở cách phân chia môi trường, quyền truy cập và trách nhiệm giữa đội data science với đội vận hành. Làm rõ những ranh giới này ngay từ đầu sẽ giúp kiến trúc MLOps dễ quản lý hơn khi hệ thống mở rộng.
Doanh nghiệp có thể tham khảo AWS Well-Architected Review từ Renova Cloud để đánh giá kiến trúc AWS hiện tại, nhận diện những điểm cần cải thiện và xác định hạng mục nên ưu tiên trước khi triển khai các khoản đầu tư lớn.
Tham khảo hướng dẫn từ Renova Cloud để triển khai MLOps chuẩn ngay từ đầu
Đội nhỏ nên bắt đầu MLOps từ đâu?
Một đội nhỏ từ 3 – 5 người chưa cần xây ngay một hệ thống MLOps phức tạp. Hãy bắt đầu từ những việc giúp quy trình ML dễ kiểm soát và có thể lặp lại:
- Version hoá trước, tự động hoá sau: Đưa code, dữ liệu, cấu hình và artifact mô hình vào version control. Đây là bước đơn giản nhưng giúp giảm nhiều lỗi khi làm việc và retrain mô hình.
- Thiết lập monitoring sớm: Ngay cả khi chưa có pipeline tự động, đội ngũ vẫn cần biết mô hình có đang drift hay hiệu suất có thay đổi theo thời gian hay không.
- Đóng gói quy trình training thành script có thể chạy lại: Chưa cần orchestrator. Chỉ cần có thể chạy lại toàn bộ quy trình từ đầu mà không phải mở từng notebook hay thực hiện thủ công.
- Thêm data validation và model validation: Đây là hai lớp kiểm tra giúp phát hiện dữ liệu bất thường và ngăn model chưa đạt yêu cầu đi tiếp vào production.
- Đưa CI/CD vào sau cùng: Khi số lượng pipeline tăng và thao tác thủ công bắt đầu trở thành điểm nghẽn, lúc đó tự động hóa sẽ mang lại hiệu quả rõ rệt hơn.
Nếu đội ngũ của bạn đang thử nghiệm GenAI hoặc ML trên AWS, có thể tham khảo thêm hướng dẫn xây chatbot RAG trên AWS và thông tin về AWS AI Services Competency của Renova Cloud để có thêm góc nhìn khi xây dựng hệ thống AI thực tế.
MLOps không phải một sản phẩm mua về rồi cài đặt. Đó là cách tổ chức lại quy trình để mô hình có thể được huấn luyện lại, kiểm định, triển khai và theo dõi một cách nhất quán, thay vì phụ thuộc vào việc một thành viên trong team còn nhớ phải làm gì sau vài tháng.
Google Cloud cũng nhấn mạnh rằng đưa ML vào production không đơn thuần là triển khai một API dự đoán. Quy trình production cần bao gồm cả pipeline có khả năng tự động retrain và triển khai model mới.
Nếu team đang muốn chuẩn hóa quy trình ML nhưng chưa biết nên bắt đầu từ đâu, hãy trao đổi ngay với đội ngũ Renova Cloud để xác định lộ trình phù hợp với quy mô và nhu cầu hiện.