 Dịch vụ
 Công nghệ
 Về Renova
 Khách hàng


LLM là gì? Mô hình ngôn ngữ lớn hoạt động thế nào và ứng dụng doanh nghiệp
Chia sẻ bài viết


Mục lục
AI đang được doanh nghiệp Việt Nam đưa vào ngày càng nhiều khâu – từ viết nội dung, phân tích dữ liệu đến chăm sóc khách hàng. Theo khảo sát State of AI của McKinsey: 88% Tổ chức đã sử dụng AI trong ít nhất một chức năng kinh doanh, nhưng chỉ 39% ghi nhận tác động đến EBIT. Nhóm tạo ra mức tăng EBIT từ 5% trở lên chỉ chiếm khoảng 6%.
Khoảng cách giữa việc “đã dùng AI” và “dùng AI ra kết quả” thường bắt đầu từ cách doanh nghiệp hiểu công nghệ. Để đưa ra quyết định đúng, doanh nghiệp cần hiểu LLM thực sự làm gì, giới hạn ở đâu và chi phí được hình thành như thế nào. Từ nguyên lý hoạt động đến các ứng dụng thực tế, những phần dưới đây sẽ giúp bạn có cái nhìn rõ hơn về công nghệ đang đứng sau làn sóng AI hiện nay.
LLM là gì?
LLM (Large Language Model – Mô hình ngôn ngữ lớn) là mô hình AI được huấn luyện trên khối lượng văn bản rất lớn để hiểu và tạo ra ngôn ngữ tự nhiên. Đây cũng là nền tảng kỹ thuật đứng sau các ứng dụng AI tạo sinh mà bạn đang dùng hàng ngày.
LLM, AI Agent và Generative AI là ba thuật ngữ mà nhiều người nhầm lẫn là 1, nhưng thực tế lại hoàn toàn khác nhau:
- LLM là mô hình chuyên xử lý ngôn ngữ.
- AI Agent sử dụng LLM để lập kế hoạch và thực hiện nhiều bước công việc.
- Generative AI là nhóm công nghệ có khả năng tạo nội dung mới.
>> Đừng bỏ lỡ:
Hiểu đơn giản: LLM là động cơ, còn chatbot, trợ lý AI hay AI Agent là những hệ thống được xây dựng quanh động cơ đó. Với doanh nghiệp, giá trị nằm ở ứng dụng thực tế, trong khi chi phí vận hành và nhiều rủi ro lại bắt nguồn từ chính mô hình bên dưới.
Mô hình ngôn ngữ lớn hoạt động thế nào?
LLM có thể được hình dung như một hệ thống xử lý ngôn ngữ theo nhiều lớp. Mô hình không “đọc hiểu” văn bản theo cách con người vẫn làm, mà biến câu chữ thành dữ liệu số, phân tích mối quan hệ giữa các phần trong câu rồi dự đoán nội dung nên xuất hiện tiếp theo. Toàn bộ quá trình có thể hiểu qua 4 bước sau:
Bước 1: Token – Cách LLM chia nhỏ văn bản
LLM không xử lý từ ngữ theo đúng cách chúng ta nhìn thấy trên màn hình. Văn bản được tách thành những đơn vị nhỏ gọi là token. Một token có thể là cả từ, một phần của từ hoặc dấu câu.
Token là đơn vị mà mô hình thực sự xử lý. Vì vậy, số lượng token ảnh hưởng trực tiếp đến chi phí sử dụng, tốc độ phản hồi và dung lượng văn bản mà mô hình có thể tiếp nhận.
Với doanh nghiệp Việt Nam, đây là một điểm dễ bị bỏ qua. Nghiên cứu Language Model Tokenizers Introduce Unfairness Between Languages tại NeurIPS 2023 cho thấy: Cùng một nội dung dịch sang các ngôn ngữ khác nhau có thể chênh lệch số token tới 15 lần, và người dùng thuộc một số ngôn ngữ phải trả chi phí cao hơn ít nhất 2,5 lần so với tiếng Anh.
Điều này có nghĩa là nếu doanh nghiệp lấy benchmark tiếng Anh để dự toán ngân sách cho chatbot hoặc ứng dụng AI tiếng Việt, chi phí thực tế có thể cao hơn dự kiến.
Bước 2: Embedding – Biến ngôn ngữ thành dữ liệu số
Sau khi được tách thành token, văn bản tiếp tục được chuyển thành các dãy số gọi là vector. Cách biểu diễn này giúp mô hình xác định mối quan hệ về ngữ nghĩa và ngữ cảnh giữa các token.
Có thể hình dung đơn giản như một bản đồ ngôn ngữ. Những khái niệm có liên hệ thường nằm gần nhau hơn, chẳng hạn “hợp đồng” và “thỏa thuận”. Những khái niệm ít liên quan như “hợp đồng” và “hải sản” sẽ nằm xa nhau hơn.
Nhờ cách biểu diễn này, LLM có thể xử lý ý nghĩa và mối liên hệ trong văn bản thay vì chỉ nhìn từng từ một cách rời rạc.
Bước 3: Attention – Xác định phần nào đáng chú ý
Đây là phần tạo nên sức mạnh của kiến trúc Transformer, được giới thiệu trong nghiên cứu Attention Is All You Need năm 2017.
Cơ chế self-attention cho phép mô hình xem xét mối quan hệ giữa các token trong cùng một ngữ cảnh và xác định phần nào có liên quan nhiều hơn đến phần đang được xử lý
Chẳng hạn, khi một câu có đại từ như “nó”, mô hình cần xem những từ xung quanh để xác định “nó” đang nói đến đối tượng nào. Với những văn bản dài và nhiều quan hệ như hợp đồng, quy trình nội bộ hay tài liệu kỹ thuật, khả năng này giúp mô hình duy trì ngữ cảnh tốt hơn.
Bước 4: Dự đoán từng token một
Sau khi phân tích ngữ cảnh, LLM tạo nội dung bằng cách dự đoán token tiếp theo dựa trên xác suất. Token được chọn sẽ trở thành một phần của câu trả lời, sau đó mô hình tiếp tục dự đoán token tiếp theo và lặp lại quá trình này cho đến khi hoàn thành.
Cơ chế này cũng lý giải một số hạn chế quen thuộc của LLM như hallucination (ảo giác), thiên lệch dữ liệu và chi phí tính toán.
Điểm cần nhớ là LLM được tối ưu để tạo ra nội dung có tính xác suất cao và phù hợp với ngữ cảnh, chứ không có cơ chế mặc định đảm bảo mọi thông tin đều chính xác. Vì vậy, một câu trả lời sai vẫn có thể được diễn đạt rất trôi chảy, tự tin và đúng ngữ pháp.
Đó cũng là lý do các ứng dụng AI trong doanh nghiệp cần có bước kiểm tra, xác thực dữ liệu và kiểm soát đầu ra thay vì mặc định xem mọi câu trả lời của mô hình là đúng.
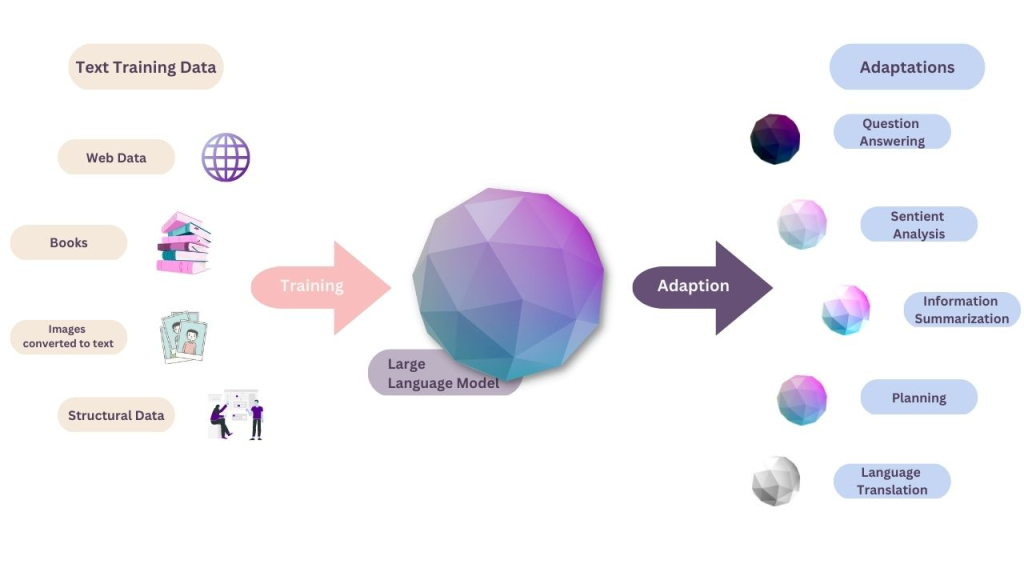
LLM biến ngôn ngữ thành dữ liệu, phân tích ngữ cảnh và dự đoán từng token để tạo ra câu trả lời phù hợp
3 Cách đưa dữ liệu doanh nghiệp vào LLM
LLM được huấn luyện trên lượng dữ liệu khổng lồ, nhưng không tự biết bảng giá, quy trình bảo hành hay hồ sơ khách hàng của riêng doanh nghiệp.
Muốn mô hình trả lời dựa trên những dữ liệu này, bạn có 3 lựa chọn phổ biến: Prompt Engineering, RAG và Fine-tuning. Mỗi cách phù hợp với một nhu cầu và mức đầu tư khác nhau.
- Prompt engineering:
Đưa thông tin trực tiếp vào câu lệnh. Rẻ nhất, nhanh nhất, phù hợp để thử nghiệm. Điểm hạn chế là bạn phải gửi lại dữ liệu trong mỗi lần gọi, trong khi lượng thông tin đưa vào cũng có giới hạn.
- RAG (Retrieval-Augmented Generation):
Cho phép hệ thống tự tìm những tài liệu liên quan trong kho dữ liệu doanh nghiệp rồi đưa chúng vào ngữ cảnh trước khi LLM tạo câu trả lời. Đây thường là lựa chọn phù hợp cho các bài toán cần khai thác tài liệu nội bộ vì dữ liệu có thể cập nhật nhanh, câu trả lời có thể truy về nguồn và không cần huấn luyện lại mô hình. Với AWS, doanh nghiệp có thể kết nối Knowledge Base với Amazon S3, để Amazon Bedrock xử lý embedding, lưu trữ vector và truy xuất dữ liệu.
>> Đừng bỏ lỡ: Hướng dẫn xây dựng chatbot RAG hỗ trợ AI với Amazon Lex, Bedrock và S3
Fine-tuning:
Phù hợp khi muốn mô hình phản hồi theo một cách nhất quán hơn, chẳng hạn về giọng văn, định dạng hoặc thuật ngữ chuyên ngành. Cách này đòi hỏi dữ liệu huấn luyện chất lượng và chi phí triển khai cao hơn.
Fine-tuning cũng không phải phương án thay thế RAG: fine-tuning giúp mô hình học cách phản hồi, trong khi RAG giúp mô hình tiếp cận thông tin doanh nghiệp đang thay đổi.
Hãy ghi nhớ: Một lỗi khá phổ biến là đầu tư ngay vào fine-tuning khi nhu cầu thực tế chỉ cần một hệ thống RAG được xây dựng tốt. Nếu mục tiêu là giúp LLM trả lời dựa trên tài liệu nội bộ, hãy thử RAG trước khi nghĩ đến việc huấn luyện lại mô hình.
5 Ứng dụng LLM trong doanh nghiệp mang lại giá trị thực tế
Thay vì chia LLM theo từng phòng ban, hãy nhìn từ dạng công việc mà AI có thể xử lý tốt. Dưới đây là 5 nhóm phổ biến mà doanh nghiệp có thể ứng dụng ngay:
Trích xuất thông tin từ văn bản phi cấu trúc
LLM có thể đọc hợp đồng, chứng từ, đơn hàng, hồ sơ vay và bóc tách những trường dữ liệu cần thiết. Đây thường là nhóm use case dễ đo lường ROI vì doanh nghiệp có thể tính trực tiếp số giờ nhập liệu thủ công được cắt giảm.
Tóm tắt tài liệu
Biên bản họp, phản hồi khách hàng, báo cáo sự cố hay hồ sơ vụ việc có thể được rút gọn thành những thông tin chính. Nhờ vậy, những tài liệu trước đây thường bị bỏ qua vì quá dài hoặc mất thời gian đọc vẫn có thể được xử lý đầy đủ.
Phân loại và gán nhãn trên quy mô lớn
Hàng chục nghìn đánh giá, ticket hỗ trợ hoặc bình luận mạng xã hội có thể được phân nhóm theo chủ đề, nhu cầu và mức độ nghiêm trọng. Thay vì chỉ phân tích một mẫu dữ liệu, doanh nghiệp có thể xử lý toàn bộ tập dữ liệu để nhìn rõ hơn các xu hướng đang diễn ra.
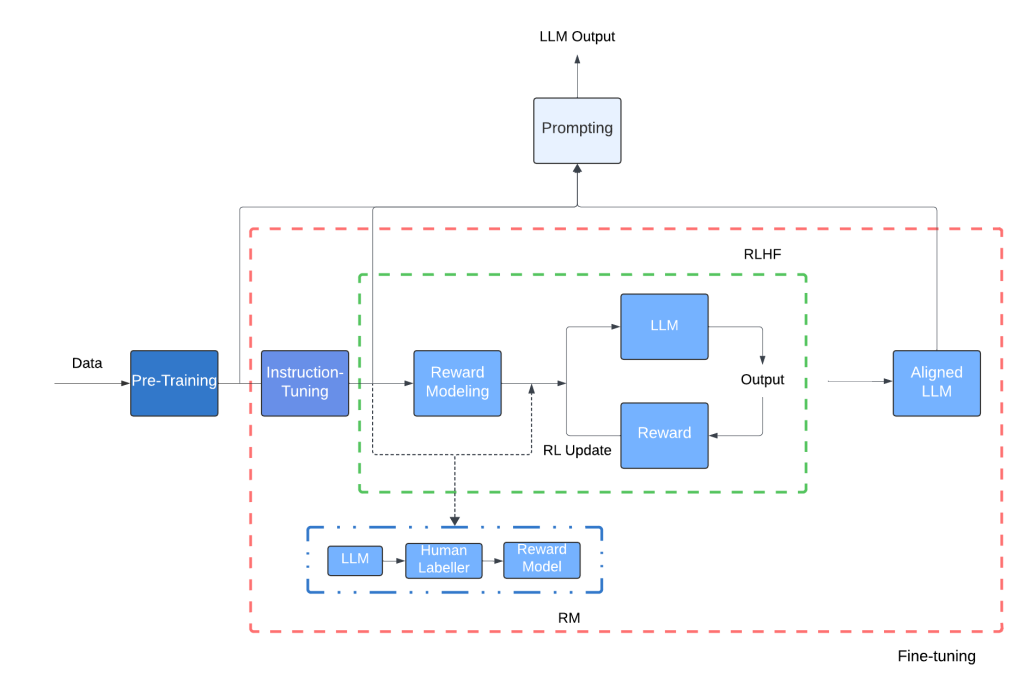
Doanh nghiệp dễ dàng khai thác toàn diện dữ liệu để phát hiện xu hướng và vấn đề nổi bật
Tạo nội dung có kiểm soát
LLM phù hợp để tạo bản nháp mô tả sản phẩm, email chăm sóc khách hàng, tài liệu kỹ thuật hoặc phản hồi khiếu nại. AI đảm nhiệm phần soạn thảo – con người kiểm duyệt trước khi nội dung được sử dụng chính thức. Cách triển khai này giúp tận dụng tốc độ của AI mà vẫn giữ được tiêu chuẩn về chất lượng và thương hiệu doanh nghiệp.
Hội thoại
LLM có thể trở thành trợ lý tri thức nội bộ, giúp nhân viên nhanh chóng tìm thông tin hoặc hỗ trợ tổng đài xử lý những cuộc gọi lặp lại. Renova đã triển khai mô hình này trong giải pháp AI Voice Bot cho contact center, với yêu cầu xử lý chính xác tên riêng, số chứng minh và số tiền bằng tiếng Việt.
Điểm chung của những dự án LLM triển khai hiệu quả là bắt đầu từ một tác vụ cụ thể, gắn với một chỉ số đo lường rõ ràng và chỉ mở rộng khi kết quả thực tế đã được chứng minh.
3 Rủi ro cần xử lý trước khi đưa vào production
Ảo giác: Câu trả lời nghe hợp lý nhưng có thể sai
Mô hình AI có thể tạo ra câu trả lời rất thuyết phục dù thông tin bên trong không chính xác. Với nội dung marketing, một lỗi nhỏ còn có thể chỉnh sửa. Nhưng trong các nghiệp vụ như tư vấn bảo hiểm hoặc xét hạn mức tín dụng, một thông tin sai có thể kéo theo rủi ro pháp lý và tài chính.
Cách xử lý hiệu quả là giới hạn đầu ra bằng nguồn dữ liệu đáng tin cậy và có bước kiểm tra lại trước khi trả kết quả. Amazon Bedrock Guardrails hỗ trợ contextual grounding check để đối chiếu phản hồi với tài liệu nguồn, giúp lọc hơn 75% phản hồi ảo giác trong các workload RAG và tóm tắt.
Automated Reasoning checks có thể xác minh các khẳng định thực tế với độ chính xác lên đến 99%. Các cơ chế safeguard này cũng được AWS công bố có khả năng chặn tới 88% nội dung có hại trên nhiều mô hình nền khác nhau.
Chi phí: PoC rẻ chưa chắc production cũng rẻ
Chi phí LLM là biến phí theo token, không phải chi phí cố định theo tháng. Một tính năng chạy tốt trong PoC với 200 người dùng có thể đội chi phí gấp nhiều lần khi mở cho 20.000 khách hàng, nhất là với tiếng Việt.
Cần ước lượng token thực tế theo từng luồng nghiệp vụ trước khi cam kết ngân sách, và thiết kế để tác vụ đơn giản dùng mô hình nhỏ hơn thay vì đưa tất cả vào mô hình mạnh nhất.
Dữ liệu và tuân thủ
Từ ngày 01/01/2026, Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 chính thức có hiệu lực. Đây là văn bản đầu tiên điều chỉnh toàn diện hoạt động thu thập, lưu trữ và xử lý dữ liệu cá nhân tại Việt Nam. Người dùng cũng có các quyền liên quan đến việc biết, đồng ý, truy cập, chỉnh sửa và yêu cầu xóa dữ liệu.
Vì vậy, việc nhân viên tự ý đưa hồ sơ khách hàng vào các công cụ AI miễn phí để tóm tắt hay phân tích có thể trở thành một vấn đề tuân thủ thực tế.
Với môi trường doanh nghiệp, hạ tầng AI cần kiểm soát rõ dữ liệu được gửi đi đâu, ai có quyền truy cập và dữ liệu có được dùng cho mục đích huấn luyện hay không.
Theo AWS: Amazon Bedrock không chia sẻ dữ liệu khách hàng với nhà cung cấp mô hình và không sử dụng dữ liệu đó để huấn luyện foundation model. Khi tinh chỉnh mô hình, AWS tạo bản sao riêng cho khách hàng, đồng thời hỗ trợ mã hóa dữ liệu khi truyền và lưu trữ, cũng như kết nối VPC thông qua AWS PrivateLink.
Ba rủi ro này thường xuất hiện ngay khi AI bước ra khỏi môi trường thử nghiệm. Xử lý chúng từ giai đoạn thiết kế sẽ giúp doanh nghiệp tránh tình trạng PoC chạy rất đẹp, nhưng đến production mới bắt đầu loay hoay với độ tin cậy, hóa đơn và dữ liệu.
Triển khai LLM trên AWS với Amazon Bedrock
Amazon Bedrock giúp doanh nghiệp tiếp cận nhiều mô hình LLM từ Anthropic, Meta, Mistral và Amazon thông qua một API thống nhất, đồng thời hỗ trợ sẵn các tính năng cho AI Agent. Đáng chú ý, các mô hình mới nhất của OpenAI (bao gồm dòng GPT-5.5, GPT-5.6 và GPT-6) cùng coding agent Codex hiện đã có mặt chính thức trên Bedrock với mức giá tương đương khi dùng trực tiếp từ OpenAI, chi phí sử dụng được tính vào cam kết AWS hiện có và dữ liệu không được dùng để huấn luyện mô hình. Nhờ đó, doanh nghiệp có thể linh hoạt lựa chọn hoặc thay đổi mô hình, giảm áp lực vận hành hạ tầng GPU và triển khai bảo mật, guardrail ngay từ đầu.
Với kinh nghiệm triển khai Generative AI trên AWS, Renova Cloud hỗ trợ doanh nghiệp từ thiết kế knowledge base, xây dựng data pipeline đến thiết lập guardrail và giám sát hệ thống trong môi trường production.
Là nhà cung cấp AWS Partner-Led Support đạt huy hiệu Backed by AWS Support – Renova Cloud là đơn vị hỗ trợ kỹ thuật 24/7 duy nhất cho doanh nghiệp bằng tiếng Việt và tiếng Anh. Đội ngũ sử dụng cùng bộ công cụ chẩn đoán với AWS Support và có thể chuyển cấp trực tiếp tới chuyên gia AWS khi cần. Nhờ đó, hệ thống Generative AI sau khi go-live được duy trì ổn định với mục tiêu phản hồi dưới 30 phút cho sự cố trọng yếu, kèm AWS Well-Architected Review miễn phí và bảng điều khiển Renovisor để theo dõi, kiểm soát chi phí vận hành sau khi go-live.
Nếu doanh nghiệp đã có PoC nhưng chưa biết cách đưa vào vận hành thực tế, hoặc đang cần xác định mô hình, kiến trúc và ngân sách phù hợp, Trung tâm AI Renova có thể cùng bạn đánh giá bài toán và xây dựng lộ trình triển khai cụ thể.
Liên hệ với đội ngũ Renova để bắt đầu từ bài toán thực tế của doanh nghiệp ngay hôm nay!
Câu hỏi thường gặp về LLM
LLM và ChatGPT khác nhau thế nào?
ChatGPT là một sản phẩm được xây dựng trên LLM của OpenAI. LLM là lớp mô hình bên dưới, còn ChatGPT là một ứng dụng cụ thể. Doanh nghiệp có thể dùng chính lớp mô hình đó qua API để xây sản phẩm riêng, với quyền kiểm soát dữ liệu hoàn toàn khác.
Doanh nghiệp có cần tự huấn luyện LLM riêng không?
Gần như không. Huấn luyện một LLM từ đầu đòi hỏi chi phí hạ tầng tính toán lên đến hàng chục triệu USD. Với phần lớn doanh nghiệp, lựa chọn thực tế hơn là kết nối dữ liệu nội bộ với mô hình có sẵn bằng RAG, sau đó fine-tune nếu cần đáp ứng yêu cầu riêng về giọng văn hoặc định dạng đầu ra.
Vì sao LLM vẫn trả lời sai dù đã được cung cấp tài liệu đúng?
Thường do khâu truy xuất chứ không phải do mô hình. Nếu hệ thống RAG lấy nhầm đoạn tài liệu, mô hình sẽ trả lời dựa trên thông tin nhầm đó. Khi gặp lỗi, hãy kiểm tra chất lượng chunking và truy xuất trước khi đổi mô hình.
Chi phí chạy LLM tiếng Việt cao hơn tiếng Anh bao nhiêu?
Chi phí phụ thuộc vào tokenizer và từng mô hình, nhưng dữ liệu đa ngôn ngữ cho thấy số token có thể chênh lệch đáng kể giữa các ngôn ngữ. Cách chính xác nhất là đo số token thực tế trên chính dữ liệu của bạn thay vì ước lượng theo benchmark tiếng Anh.
Nên bắt đầu từ use case nào?
Chọn một quy trình có khối lượng lớn, lặp lại nhiều lần, chủ yếu xử lý văn bản và có thể đo hiệu quả bằng số liệu. Các bài toán như trích xuất, phân loại hoặc tóm tắt tài liệu thường là điểm khởi đầu tốt vì dễ triển khai và nhanh chóng chứng minh giá trị qua thời gian xử lý hoặc năng suất.